Introducción
La detección de outliers es un desafío crítico en el análisis de datos multivariados, con implicaciones en aplicaciones que van desde la detección de fraude hasta el análisis de datos biomédicos. Los outliers pueden aportar información valiosa o, por el contrario, llevar a conclusiones erróneas si no se manejan adecuadamente.
En este estudio profundizamos en tres metodologías para identificarlos: la tradicional distancia de Mahalanobis[1], su adaptación robusta[2,3] y el método Isolation Forest[4]. Cada técnica aborda el problema desde un enfoque distinto, y compararlas directamente permite entender sus fortalezas y limitaciones en un contexto práctico, así como su efecto en la precisión de los modelos predictivos.
Metodología
Aplicamos tres técnicas distintas de detección de outliers sobre un conjunto de datos multivariante y evaluamos cómo su limpieza afecta a dos modelos de clasificación.
Dataset
Utilizamos el conjunto de datos Churn Modelling de Kaggle, ampliamente usado en el análisis predictivo de la rotación de clientes en banca. Contiene 10,000 registros con información demográfica, de productos y de comportamiento de los clientes de un banco. Los campos clave son:
CustomerIdidentificador único del clienteSurnameapellido del clienteCreditScorepuntuación de créditoGeographypaís de residenciaGendergéneroAgeedadTenureaños como cliente del bancoBalancesaldo bancarioNumOfProductsnúmero de productos contratadosHasCrCardtiene tarjeta de créditoIsActiveMemberes miembro activoEstimatedSalarysalario estimadoExitedabandonó el banco (variable objetivo)
Técnicas de detección de outliers
Distancia de Mahalanobis
La distancia de Mahalanobis[1] mide qué tan lejos está un punto de una distribución, teniendo en cuenta la correlación entre variables:
donde \(\vec{x}\) es el vector de observación, \(\vec{\mu}\) el vector de medias de la muestra y \(\boldsymbol{\Sigma}\) la matriz de covarianza, que captura las covarianzas entre cada par de variables.
Distancia de Mahalanobis robusta
La versión robusta[3] evita que los propios outliers distorsionen la media y la covarianza. Para ello las estima con el algoritmo de determinante de covarianza mínimo (MCD)[2] y calcula la distancia de la misma forma:
import numpy as np
from sklearn.covariance import MinCovDet

# Minimum Covariance Determinant
robust_cov = MinCovDet().fit(data[numerical_cols])

# Media y covarianza del estimador robusto
robust_mean = robust_cov.location_
robust_cov_matrix = robust_cov.covariance_
robust_cov_matrix_inv = np.linalg.inv(robust_cov_matrix)

def mahalanobis(x, mean, inv_cov_matrix):
    x_minus_mu = x - mean
    return np.dot(np.dot(x_minus_mu, inv_cov_matrix), x_minus_mu.T)
Cálculo de la distancia de Mahalanobis robusta en Python con scikit-learn.
Isolation Forest
Isolation Forest[4] no mide distancias: aísla los puntos. Construye árboles aleatorios que, en cada nodo, eligen un atributo al azar y un valor de corte entre su mínimo y su máximo. Un outlier necesita pocas divisiones para quedar aislado, así que la profundidad media se convierte en un puntaje de anormalidad:
donde \(E(h(\vec{x}))\) es el número promedio de divisiones necesarias para aislar \(\vec{x}\) y \(c(n)\) es un factor de normalización que depende del tamaño de la muestra \(n\).
Modelos de clasificación
Regresión logística
Estima la probabilidad de que una observación pertenezca a la clase positiva:
donde \(\beta_0, \dots, \beta_n\) son los coeficientes del modelo y \(x_1, \dots, x_n\) las características de la observación.
Máquinas de vectores de soporte (SVM)
Buscan el hiperplano que mejor separa las clases en el espacio de características:
donde \(\mathbf{w}\) es el vector de pesos, perpendicular al hiperplano, y \(b\) el término de sesgo.
Métricas de evaluación
Usamos cuatro métricas, expresadas en términos de verdaderos positivos (VP), falsos positivos (FP) y falsos negativos (FN):
La precisión mide cuántas predicciones positivas son correctas; el recall, cuántos positivos reales detecta el modelo; el F1 equilibra ambas, y el AUC resume la capacidad de distinguir entre clases (1 es perfecto; 0.5 equivale al azar).
Resultados
Consideraciones previas
Más de un tercio de las cuentas tiene saldo cero, así que dividimos los datos en dos grupos:
| Balance (saldo) | Cantidad | Proporción |
|---|---|---|
| Saldo positivo | 6,383 | 63.83% |
| Saldo nulo (0) | 3,617 | 36.17% |
- Para la limpieza de datos nos centramos en el grupo con saldo positivo.
- La edad presenta asimetría positiva, por lo que aplicamos una transformación logarítmica antes de calcular las distancias de Mahalanobis.
- Para Isolation Forest proyectamos los datos con PCA y así visualizar mejor el patrón de los puntos anómalos.
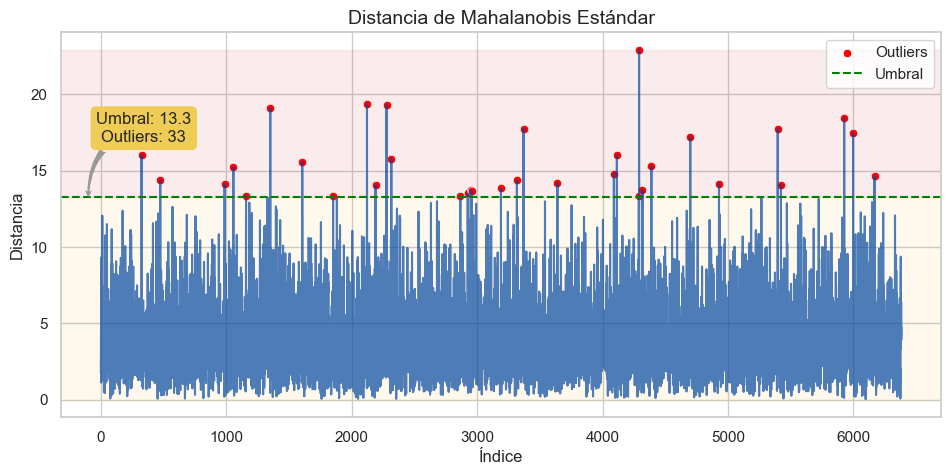
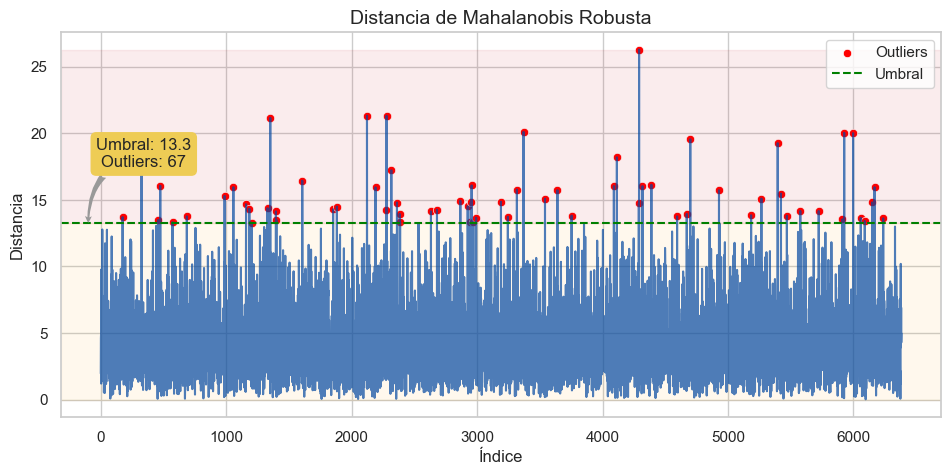
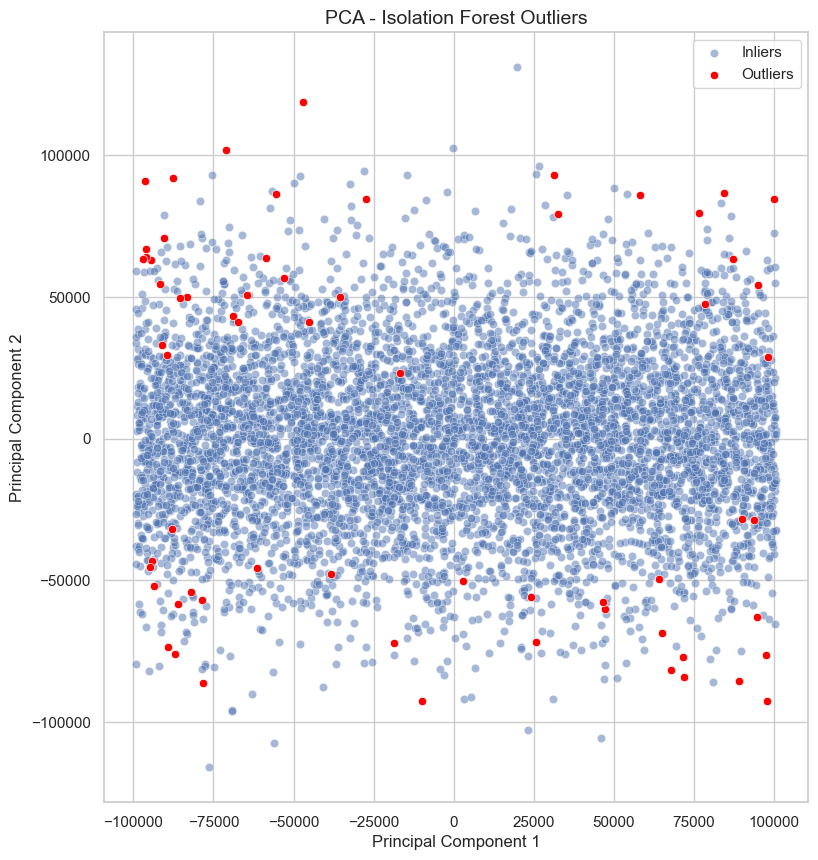
Con cada una de las tres limpiezas entrenamos dos modelos, regresión logística y SVM, y los evaluamos con precisión, recall, F1 y AUC.
Impacto en la regresión logística
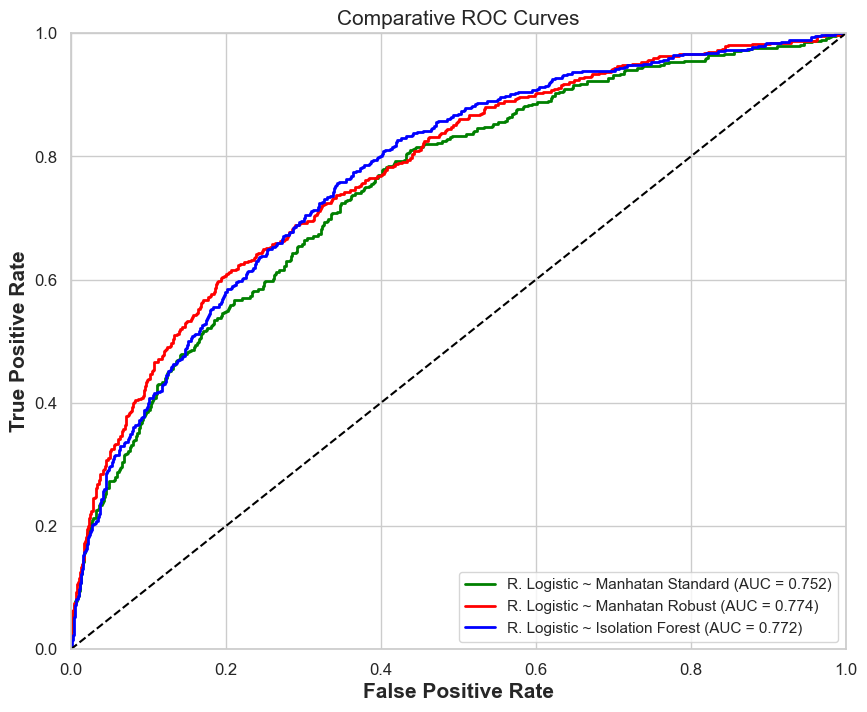
La distancia de Mahalanobis estándar ofreció un AUC de 0.752, mientras que la versión robusta e Isolation Forest alcanzaron 0.774 y 0.772, una ligera mejora en la capacidad de discriminación. En precisión, recall y F1, en cambio, la distancia estándar mostró un rendimiento más consistente, especialmente en recall y F1.
Impacto en SVM
| Limpieza | Precisión | Recall | F1 | AUC |
|---|---|---|---|---|
| Mahalanobis estándar | 55.21% | 63.84% | 59.21% | 0.808 |
| Mahalanobis robusta | 55.76% | 70.28% | 62.21% | 0.817 |
| Isolation Forest | 50.54% | 72.68% | 59.62% | 0.825 |
Isolation Forest maximiza el recall y el AUC, pero a costa de la precisión. La distancia de Mahalanobis robusta logra el mejor equilibrio entre precisión y recall, con el F1 más alto (62.21%) y un AUC de 0.817.
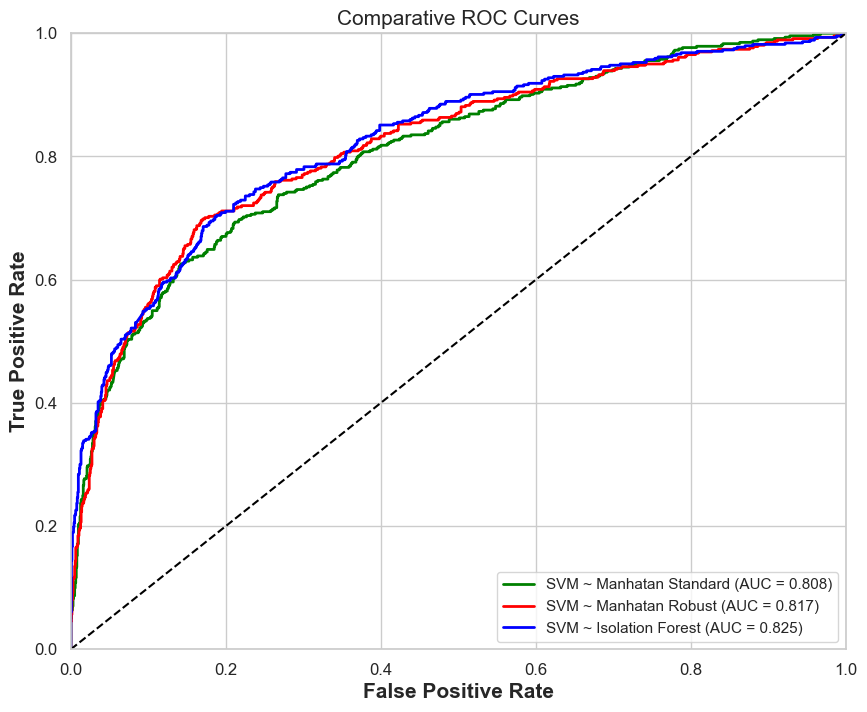
En la práctica: la elección depende del objetivo. Si importa no dejar escapar a ningún cliente en riesgo, Isolation Forest ofrece el mayor recall; si se busca un balance entre aciertos y falsas alarmas, la distancia de Mahalanobis robusta es la opción más equilibrada.
Conclusiones
Este estudio analizó el impacto de distintas técnicas de tratamiento de outliers en la eficacia de la regresión logística y SVM para predecir la fuga de clientes bancarios. Los resultados indican que elegir bien el método de limpieza es fundamental para optimizar los modelos predictivos.
En la regresión logística, técnicas como la distancia de Mahalanobis robusta mejoran la capacidad de discriminación del modelo. En SVM, la versión robusta emergió como la técnica más equilibrada, con el F1 más alto y un AUC consistente.
La implicación práctica es clara: un preprocesamiento adecuado mejora la identificación de clientes con alta probabilidad de abandono y permite a las instituciones bancarias intervenir de forma proactiva para retenerlos.
Referencias
- Mahalanobis PC. On the generalized distance in statistics. Proceedings of the National Institute of Sciences of India. 1936;2(1):49–55.
- Rousseeuw PJ, Van Driessen K. A fast algorithm for the minimum covariance determinant estimator. Technometrics. 1999;41(3):212–223. doi:10.1080/00401706.1999.10485670
- Cabana E, Lillo RE, Laniado H. Multivariate outlier detection based on a robust Mahalanobis distance with shrinkage estimators. Statistical Papers. 2021;62:1583–1609. doi:10.1007/s00362-019-01148-1
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. En: 2008 Eighth IEEE International Conference on Data Mining. 2008:413–422. doi:10.1109/ICDM.2008.17